Saiu o Claude Fable 5.2: o que muda (e se a sua empresa precisa dele)
Mais rápido, 20% mais barato e mais honesto quando não sabe. O resumo do lançamento sem hype, e o que fazer com ele numa empresa de serviço.
No dia 9 de novembro, a Anthropic lançou o Claude Fable 5.2, a nova versão do seu modelo mais avançado. Junto veio o Claude Mythos 5.2, que é o mesmo modelo com menos travas para segurança digital e biologia, liberado só para organizações aprovadas em programas de verificação.
Toda vez que sai um modelo novo, a internet enche de print de benchmark. Aqui vai o resumo do que importa para quem tem uma empresa de serviço, e do que eu faria com isso.
O que mudou
- Mais rápido. Segundo a Anthropic, ele gera respostas até 30% mais rápido que o Fable 5.1.
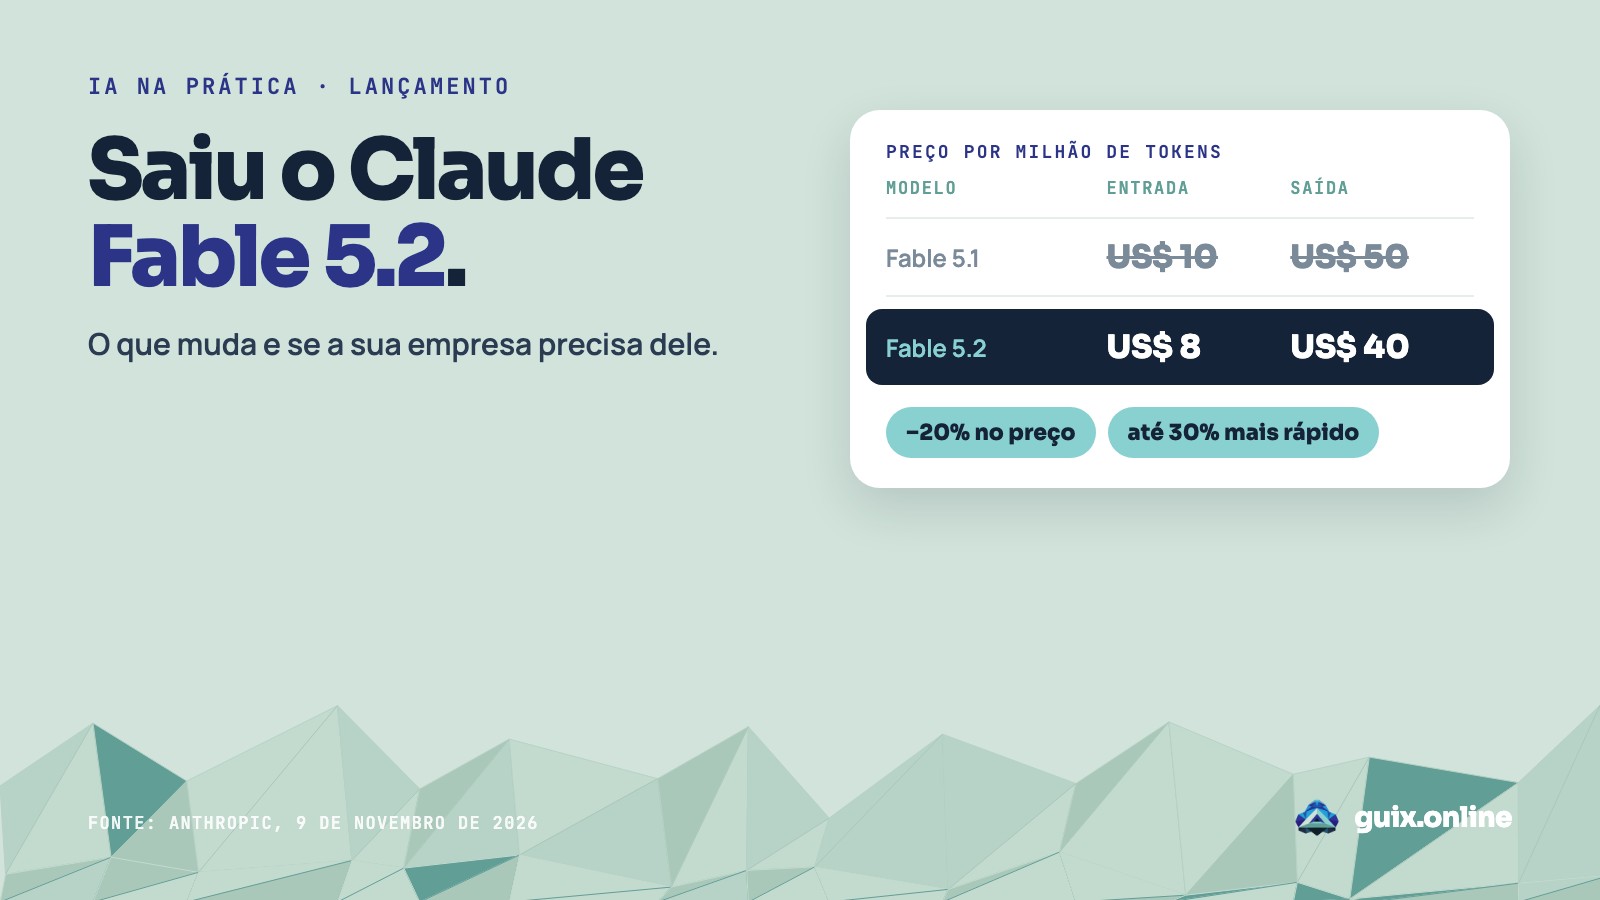
- Mais barato. O preço caiu 20%: US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de saída (o 5.1 custava US$ 10 e US$ 50). Existe também um modo rápido, até 2,5 vezes mais veloz, pelo dobro do preço.
- Melhor em quase tudo que foi medido. Código, raciocínio, pesquisa, leitura de gráficos e tarefas de escritório. Na tabela de testes da Anthropic, ele fica acima do Opus 5.5 na maioria das provas.
- Comunica com mais clareza. É o que os testadores relataram, e é o tipo de coisa que pesa no dia a dia.
O que mais me chamou atenção
Não foi o benchmark. Foram dois relatos de quem testou.
O primeiro é sobre honestidade. Um dos testadores contou que o modelo admitiu quando não sabia, em vez de inventar, e se recusou a dar um número antes de medir. Nos testes internos da Anthropic, a versão sem travas do modelo também inventou menos informação e afirmou menos vezes ter terminado uma tarefa que não terminou.
O segundo é sobre conta certa. A Oracle pediu a três modelos uma consulta de banco de dados para somar valores de um relatório. As três rodaram sem erro. Mas duas somaram errado e entregaram números de 5 a 8 vezes maiores que o real. O Fable 5.2 acertou.
Para uma empresa de serviço, isso é o que importa. Um relatório financeiro, uma proposta ou um contrato não pode ter número bonito e errado. Modelo que avisa quando não sabe dá menos retrabalho que modelo confiante demais.
Você precisa dele?
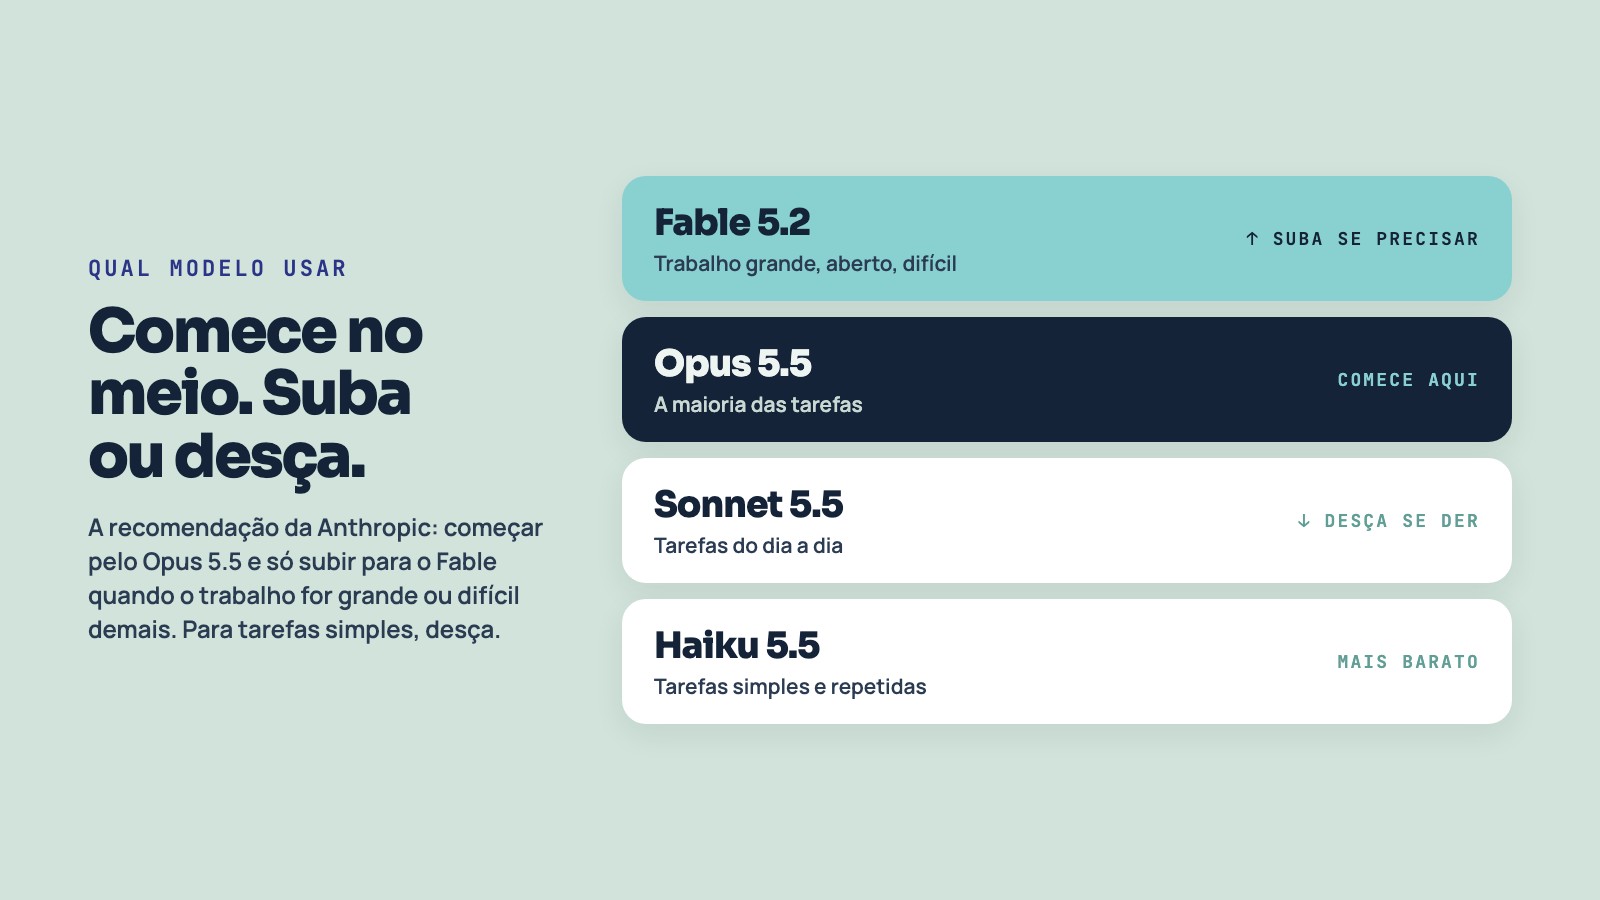
Provavelmente não para tudo. E quem diz isso é a própria Anthropic: para a maioria das tarefas de código e de conhecimento, a recomendação é começar pelo Opus 5.5 e só subir para o Fable quando o trabalho for grande, aberto ou difícil demais. Para tarefas simples, dá até para descer para o Sonnet ou o Haiku, que são mais baratos.
É a mesma lógica que eu uso nos projetos: prova o conceito primeiro, depois efetiva o custo. Você testa a tarefa nos modelos mais fortes, vê se resolve, e desce até o mais barato que ainda entrega.
O que eu faria agora
- Não troque tudo no dia do lançamento. Modelo novo pode mudar o jeito de responder, e quem usa a API tem algumas mudanças técnicas para revisar antes.
- Rode suas tarefas de teste. Pegue 5 ou 10 casos reais da sua operação (uma proposta, um resumo de reunião, uma planilha) e compare o resultado e o custo.
- Ficou melhor ou mais barato? Troque. Se o seu sistema foi montado com o modelo trocável, isso é uma configuração, não uma obra.
Esse lançamento é mais uma prova de que a IA anda rápido. O melhor modelo de hoje vira o segundo em poucos meses. Por isso a sua empresa não pode ficar presa a um modelo nem a uma empresa só.
Modelo é peça. A solução é sua.
Se você quer saber onde a IA entra na sua operação, e qual modelo vale a pena pagar para cada tarefa, faz o diagnóstico gratuito.
Fontes: anúncio da Anthropic e documentação do Claude Fable 5.2, ambos de 9 de novembro de 2026.